نیاز و پوشش
داده، وابستگیها، مالک خدمت و هدف بازیابی را ثبت کنید.
در حال آمادهسازی صفحه
سرور جایگزین و دسترسپذیری بالا؛ راهنمای افزونگی، تشخیص خرابی، failover، جلوگیری از دو مرجع نوشتن و حفظ بکاپ مستقل.
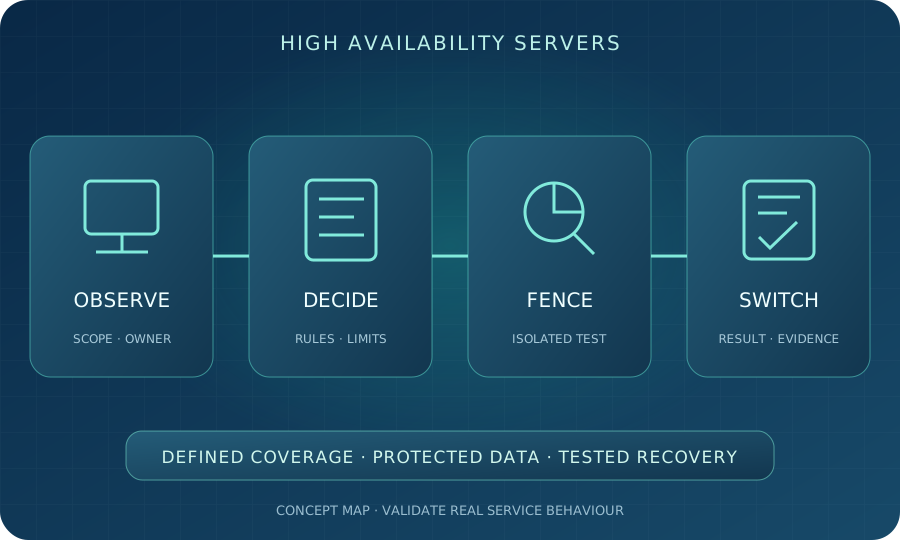
نقشهٔ آموزشی؛ وجود فایل بکاپ یا سرور جایگزین، بهتنهایی شاهد بازیابی موفق خدمت نیست.
High Availability یا دسترسپذیری بالا برای کاهش توقف خدمت در خرابیهای تعریفشده طراحی میشود. سرور دوم ممکن است آمادهٔ جایگزینی باشد، اما اگر همان برق، ذخیرهسازی یا حساب آسیبپذیر را داشته باشد، ریسک مشترک باقی میماند. این راهنما کمک میکند قبل از خرید سرور، دامنهٔ افزونگی و معیار تحویل واقعی را مشخص کنید؛ هیچ کلاستر تولیدی جدید در این پروژه راهاندازی نمیشود.
داده، وابستگیها، مالک خدمت و هدف بازیابی را ثبت کنید.
روش، محل نگهداری، اختیار اجرا و مسیر خطا را مشخص کنید.
بازیابی و پذیرش برنامه را در محیط مجاز و جدا بررسی کنید.
شاهد آزمون، مسئول پیگیری و برنامهٔ بازآزمون را نگه دارید.
خرابی میزبان، برنامه، دیتابیس و مسیر ارتباطی را جدا بررسی کنید. ممکن است دو سرور سالم باشند اما سرویس به دلیل ذخیرهسازی مشترک قطع شود. نقشهٔ وابستگی و نقاط تکخرابی را تهیه کنید. HA باید برای سناریوهای مشخص طراحی شود؛ کاهش توقف بعضی خرابیها به معنی حفاظت برابر در قطع کامل سایت یا حادثهٔ امنیتی نیست.
آمادهبهکار بودن، فعال/غیرفعال یا معماریهای دیگر را با محصول و نیاز برنامه مقایسه کنید. سرور جایگزین باید توان بار باقیمانده را داشته باشد؛ نتیجهٔ آزمون کمبار را برای ساعت شلوغ تعمیم ندهید. نسخهٔ نرمافزار، پیکربندی، مجوز و اتصال کاربران نیز باید با نقش جدید سازگار باشند تا فقط عنوان سرورها عوض نشود.
مستند standby در PostgreSQL توضیح میدهد که تکثیر ناهمگام میتواند هنگام خرابی فاصلهٔ داده ایجاد کند. مدل همگام نیز هزینه و شرایط انتظار خود را دارد. انتخاب روش باید با نیاز و محصول تأیید شود. تکثیر، نسخهٔ تاریخی مستقل نیست؛ خطای داده ممکن است به سمت جایگزین هم منتقل شود.
قطع پیام سلامت همیشه به معنی خاموش شدن سرور نیست؛ ممکن است مسیر شبکه قطع باشد. معیار سلامت را با خدمت و نقش منبع هماهنگ کنید. مسئول تصمیم، آستانه، زمان تشخیص و رفتار هشدار باید روشن باشند. اجرای خودکار بدون جلوگیری از تصمیم متناقض میتواند خطرناکتر از توقف کوتاه و قابل کنترل باشد.
اگر هر دو سمت خود را مرجع نوشتن بدانند، داده میتواند ناسازگار شود. راهنمای failover در PostgreSQL ضرورت جلوگیری از فعال شدن دوبارهٔ مرجع قبلی را توضیح میدهد. طراحی کنترل نقش و fencing باید با ابزار منتخب آزموده شود؛ این مقاله فرمان قطع یا ارتقای سرور زنده ارائه نمیکند.
پس از جابهجایی، برنامه باید مقصد معتبر را پیدا کند و اتصالهای قدیمی را مدیریت کند. پاسخ شبکه با موفقیت عملیات کاربر یکی نیست. تراکنش نیمهتمام، تلاش مجدد و ثبت تکراری را با دادهٔ آزمایشی بررسی کنید. تعریف موفقیت باید از دید برنامه باشد، نه فقط سبز شدن ابزار پایش ماشینها.
HA جای بکاپ مستقل و برنامهٔ بازیابی بحران را نمیگیرد. پس از جایگزینی ممکن است فقط یک سمت باقی بماند؛ مسئول بازسازی و کنترل همگام شدن را تعیین کنید. برگشت میزبان قبلی نباید خودکار به نوشتن دوباره منجر شود. روش نگهداری و تغییر نسخه نیز باید با مسیر نقشها و توان بازگشت هماهنگ باشد.
در محیط آزمایشی یا پنجرهٔ دارای مجوز، قطع مسیر، خرابی منبع، برگشت ارتباط و راهاندازی عضو قبلی را بررسی کنید. نتیجهٔ عملیات برنامه، وضعیت داده و زمان توقف را ثبت کنید. تحویل شامل نقشهٔ نقشها، دامنهٔ خرابی، رفتار جابهجایی و مسئول بازیابی افزونگی است. وعدهٔ توقف صفر یا از دست نرفتن داده بدون شرایط و شاهد معتبر مناسب نیست.
نوع سرویس، حجم تقریبی داده، هدف زمان بازیابی و شرایط نگهداری را مشخص کنید تا دامنهٔ کار و معیار پذیرش قابل تعریف باشند. تعداد کاربران و هدف بررسی را در بخش پشتیبانی ویوان نت توضیح دهید؛ رمز، کلید یا تنظیمات محرمانه را در درخواست معمولی نفرستید.
یک برنامهٔ فرضی دیتابیس اصلی و سرور آمادهٔ جایگزین دارد. در تمرین مجاز، مسیر بین آنها قطع میشود ولی هر دو ماشین روشناند. تیم بررسی میکند که تنها مرجع تأییدشده اجازهٔ نوشتن داشته باشد. بعد از برگشت مسیر، میزبان قبلی بدون کنترل نقش فعال نمیشود و دادهها بازبینی میشوند؛ روشن بودن دو ماشین، معیار سلامت کل خدمت نیست.
این مثال آموزشی است، نه پروژهٔ واقعی یا نتیجهٔ عددی ویوان نت؛ روش اجرا و آزمون باید با بستر و اختیار سازمان هماهنگ شوند.
این راهنما از مجموعهٔ پشتیبانگیری و بازیابی اطلاعات ویوان نت است. برای شناخت مجموعه، معرفی ویوان نت را ببینید.
خیر؛ داده، تصمیم جابهجایی، شبکه، ظرفیت و رفتار برنامه باید طراحی و آزموده شوند.
نه؛ حذف یا خرابی منطقی ممکن است تکثیر شود و نسخهٔ مستقل همچنان لازم است.
خیر؛ جایگزینی در دامنهٔ مشخص، با برنامهٔ بازگردانی بحران و سناریوهای گستردهتر یکسان نیست.
وضعیتی که چند سمت خود را مرجع میدانند؛ برای جلوگیری از نوشتن متناقض باید کنترل نقش طراحی شود.
خیر؛ فاصلهٔ انتقال یا اعمال تغییرات میتواند در خرابی اثر داشته باشد.
بدون دامنه، شرایط و آزمون معتبر چنین وعدهای قابل اتکا نیست؛ نتیجهٔ واقعی باید اندازهگیری شود.
منابع برای مبانی و نمونهٔ روشها هستند؛ انتخاب محصول، ظرفیت و تنظیمات واقعی باید در زمان اجرا و بستر سازمان بررسی شوند.
از نیاز واقعی و محدودیتهای مجموعه شروع میکنیم؛ طراحی و آزمون باید با بستر و اختیار سازمان هماهنگ شوند.
ثبت درخواست مشاوره ←